InnoDB 的事务与锁
最经典的概念:ACID
数据库的入门教程,都会对数据库概念的历史发展做一介绍,理论上,任何存储数据的介质都可以被称为数据库。比如,最早的纸质记录,计算机出现以后的文件记录(类似 excel),基于独立文件的早期简单数据库,关系模型以及建立在其上、统治数据库行业数十年的关系型数据库,以及之后出现的针对关系型数据库不足而研发的其他数据库,比如 mongoDB、ES、图数据库,以及面向 BI 的数据仓库等等。这些都可以称为数据库。
而最经典的关系型数据库,因为其面向的业务十分广泛,其中不少业务对于数据准确性的要求堪称严苛,比如说:银行系统、电子商务下单系统,等等。这些数据半点也不能错。而一次业务操作,很有可能涉及一张表的多条记录,也有可能涉及多张表。比如:转账要扣减转出者的余额、增加转入者的余额,准确地说,这是两个操作,而数据库必须保证这两件事情是作为整体发生的,因此,这样的一系列有关联的操作,在数据库里被抽象成了一个概念:事务
所以我理解:事务,就是一系列业务上有关联的操作。
而事务最重要的特性,就是我们耳熟能详的:ACID
可以说,关系型数据库设计中最重要的问题,就是妥善实现事务的 ACID,我们再来看一下 ACID 的基本概念:
A:原子性。即一个事务中的所有操作,要么全部完成,要么全部不完成;
C:一致性。即一个事务在开始前和结束后,数据库的状态必须是满足所有预想的约束规则的。(比如转账,那钱不可能凭空多出来,一定是一个账户钱少了、另一个账户钱多了)
I:隔离性。即事务之间不会相互影响,多个事务并发执行时,不会破坏单个事务的一致性。
D:持久性。事务结束以后,对数据的修改就是永久的,即使系统故障,数据也不会丢失。一般这种持久性的保证就是磁盘落盘完毕。
ACID 是保证数据正确性的重要措施,而因为单个数据库往往服务于多个上层应用,如果要求上层应用实现 ACID,则难度过高,甚至于不可能。因此,ACID 作为事务最重要的特性,必须由数据库来实现。
显然,我们把所有的事务都序列化执行,那么就不会有任何问题。但这样效率实在太低了,而且一个数据库实例将只能同时服务于一个客户端,显然也无法接受。因此,事务一定要允许并发。而所有复杂的锁设计,其实都是在尽量提高数据库性能,和尽量保证 ACID 之间求得一个平衡。根据我们上一次的分享,mysql 与客户端的每一个连接,都会有一个独立的线程与之对应,因此,事务的并发,从编程的角度去看,本质上是多线程同时操作同一个数据导致的并发问题。
事务并发的问题-脏读、不可重复读、幻读、更新丢失、回滚覆盖
那么,事务并发可能会有哪些问题呢?
- 脏读。
事务 A 的修改尚未提交,而事务 B 开始了,此时事务 B 读到了事务 A 尚未提交的数据。

-
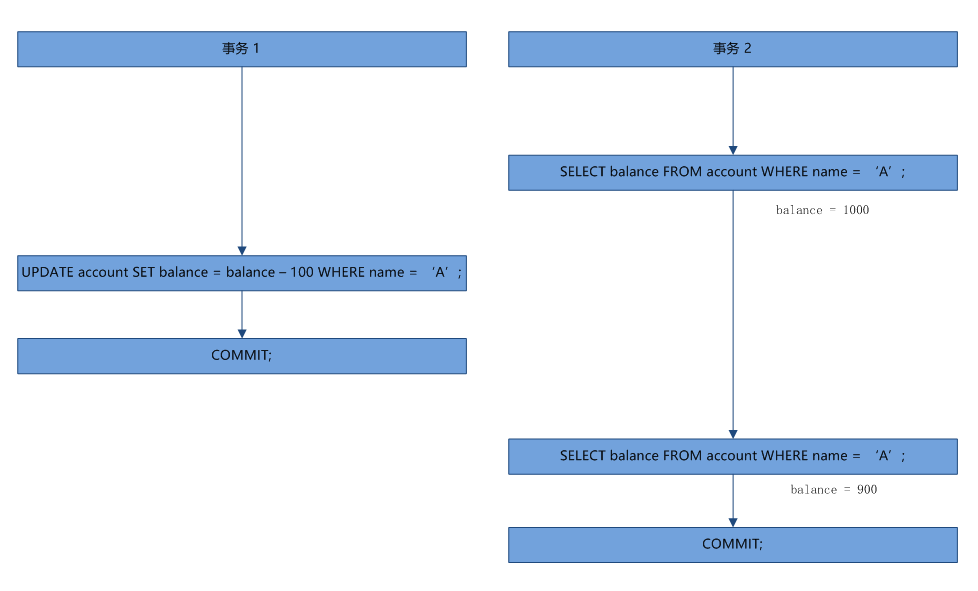
不可重复读
事务 A 开始了,事务 B 开始了,事务 B 读了一个数据,事务 A 修改了这个数据,事务 A 结束了,事务 B 重新读取了这个数据,发现自己读到的数据和第一次不一致。
-
幻读
之前的两种并发问题,都是事务并发操作同一条数据时出现的问题,而幻读是指:事务 A 开始了,事务 B 开始了,事务 B 扫描了一个范围的数据,事务 A 插入了一条数据,事务 B 重新扫描这个范围的数据,发现多了一条数据,就像幻影一样,因此称之为幻读。

-
丢失更新
事务 A 开始了,他要从小马的账户里扣 100块钱,查询小马的账户余额,发现有 1000;此时事务 B 开始了,他要从小马的账户里增加 100 块钱,它查询小马的账户里有 1000,然后它加了 100,变成 1100,事务 B 结束。事务 A 继续,它将 1000 减去 100,变成 900,事务 A 结束。
此时,事务 B 的操作丢失了。

-
回滚覆盖
事务 A 开始了,查询小马账户,1000 元,事务 B 开始了,将小马账户增加了 100 元,事务 B 结束,此时小马账户里有 1100 元,事务 A 回滚,数据被覆写回 1000。一个错误的事务,导致一个正常执行的事务结果丢失,这是最严重的事务并发问题,在所有的数据库、所有的隔离级别下都不允许发生这样的问题。

现在我们知道了,为了提高数据库性能,所以我们必须支持事务并发,而事务并发又有可能破坏 ACID,因此,根据业务评估,允许在一定程度上破坏事务的 ACID 特性,这就是数据库隔离级别干的事情,而实现事务并发时的数据隔离方案,就成了数据库实现的重中之重。
四种隔离级别
SQL 标准定义了四种隔离级别,分别解决不同的事务并发问题。(隔离级别就是不同程度的并发控制手段)
- 读未提交(Read Uncommited)。一个事务可以读到另一个事务未提交的修改;
- 读已提交(Read Commited)。一个事务可以读到另一个事务已提交的修改,但不可重复读。
- 可重复读(Repeatable Read)。一个事务反复读同一条数据,不会发生变化。但可能幻读。
- 完全序列化。多事务排队执行,不会有任何并发问题,这个级别解决了一切并发问题。
更详细一点的图如下
| 隔离级别 | 回滚覆盖 | 脏读 | 不可重复读 | 提交覆盖 | 幻读 |
|---|---|---|---|---|---|
| 读未提交 | ❌ | ✔️ | ✔️ | ✔️ | ✔️ |
| 读已提交 | ❌ | ❌ | ✔️ | ✔️ | ✔️ |
| 可重复读 | ❌ | ❌ | ❌ | ✔️ | ✔️ |
| 序列化 | ❌ | ❌ | ❌ | ❌ | ❌ |
这是经典的隔离级别,但不同数据库隔离级别的实现不尽相同,比如,Oracle 就没有实现可重复读,它实现了一个 read-only 级别,在这种级别下也可重复读,但不可以做修改操作,而但 mysql 的特殊实现,使得在 RR 隔离级别下,也避免了幻读,而且 mysql 的默认隔离级别就是 RR
插一句话:commit and buffer pool
之前我是准备从 Insert 插入时到底发生了什么开始讲的,但是发现这个路径不通。因为如果要讲这个,就必然讲到各种锁,如果要讲到各种锁,就得讲为什么会需要这些锁,要讲为什么需要这些锁,就必须要讲到 ACID,讲到事务隔离级别。所以最终还是决定用最经典的 ACID 概念作为引入。
但我最初为什么想要从 Insert 开始引入呢?因为我自己也有个疑惑,那就是,所有的 DML 操作,到底将改动写入 buffer pool 的操作是在 commit 前,还是在 commit 后?经过上次的分享我们知道,客户端读到的所有数据,都来自于 buffer pool,假如 buffer pool 中不存在数据,那也是从磁盘中先加载到 buffer pool 中,再返回给客户端的。那么,当事务修改一个数据时,到底是 commit 以后才去修改 buffer pool,还是 commit 以前就修改了 buffer pool。如果在commit 以前就修改了,此时有其他线程来读该数据,会读到什么数据呢?如果是之后,那不可重复读是如何解决的?
经过查找,我发现了这么一张图:

这是 update 语句,而 insert 语句没找到类似的图,但有一篇文章指出(实际写完这个文档以后再回头看这个问题,就很简单了,显然是先写 buffer pool 的):
- 开始执行事务,获取相关锁
- 记录undolog (保证事务原子性,先写undolog回滚日志,逻辑日志,记录在ibdata1文件,理解为修改数据之前备份在别的地方去, 也用于实现MVCC)
- 记录redolog (保证事务持久性,INNODB记录redo log 重做日志,redolog为物理日志,对应文件为ib_logfileN,redolog是顺序循环写,相对高效。与undo log同时在事务进行中持续写)
- 修改数据,修改后的数据进入innodb buffer pool (未提交,属于脏事务)
- 事务提交。redo log 和 binlog 双落盘,此时就发生了我们上次所说的两阶段提交。
而删除同理,在 InnoDB 中,删除并不会立即将数据删除,而是将数据标记为已删除,一样是先写 buffer pool,之后定期刷入磁盘页中。(不然假如 delete 是直接删除 buffer pool 中的数据,那 delete 之后立即查询的话,buffer pool 中没有这个数据,磁盘中有,就有问题)
因此,在 InnoDB 中,所有的 DML,都是先写 buffer pool,之后再提交事务。知道这个时机问题以后,我们本能地会去想,要实现不同的隔离级别,则要使用锁,通过锁定某些资源并控制解锁的时机,来实现事务的隔离级别。
那么,回滚显然也是一种写操作,而回滚又是怎么发生的呢?
众所周知,回滚依赖于回滚日志,那么什么是回滚日志,在何时记录回滚日志呢?
InnoDB:undo log;官方文档:undo logs;数据库月报:InnoDB undo log
整理以上文章的内容可知,undo log 是逻辑日志,记录的内容大致为:主键为 A 的数据,其 X 列更新前的数据是什么。
undo log 记录的时机是:当开启一个读写事务时(或者从只读事务转换为读写事务)时,InnoDB 开始记录回滚日记。
undo log 使用的时机是,当事务要回滚时;
undo log 使用的方式是:逆向执行事务操作。比如一个 insert 对应一个 delete,一个 update 对应一个 update 旧值。
回滚操作也一样是先修改 buffer pool。
这里没有深入去讲 undo log,因为时间上也不允许,但以后在说到其他问题时,还会提到 undo log,因为 undo log 和 mysql 的另一个重要概念:多版本并发控制也有关系。
隔离级别的实现
基于锁的并发控制
事务和隔离级别的概念,都是 SQL 标准中明确规定的,但如何实现这些概念,SQL 标准并无规定,因此,各个数据库对此的实现五花八门,一言以蔽之,复杂的锁设计都是为了实现不同的隔离级别,但是,隔离级别的实现并不一定完全要借助锁。
传统的基于锁的隔离级别实现,称为基于锁的并发控制(Lock-Based Concurrent Control,简写 LBCC),假如要我们自己来通过锁来实现并发控制,那我们会怎么做呢?我自己琢磨了一下,会这样。
- 读未提交
不加锁,事务并发读写不做控制。
-
读已提交
写时加持续写锁,不允许任何其他事务读和写,而读时加临时读锁,读操作结束后立即释放的那种,这样,对一条数据的读会被阻塞在其他事务对该数据的写操作上,直到该事务写完才能读,这样就是读已提交。但是,因为读锁加的是短读锁,一次读完之后,其他事务可以写,所以该事务二次读时可能数据不一致。
-
可重复读
写时加持续写锁,不允许其他任何事务的读和写,而读时加持续读锁,阻塞其他写但不阻塞读。这样,不但解决了读已提交问题,还使得一条数据的读同样阻塞其他线程对该数据的写,因此多次读的结果是一致的,解决了不可重复读问题。
-
序列化
读写都加表锁,直接干掉所有多线程问题。
不过看了经典的实现以后,我发现我的这个实现还差一点,因为正如上所言,回滚覆盖在任何隔离级别都不允许有,所以假如我们不加任何锁,那么就可能发生回滚覆盖。

因此,实际上各个数据库在实现读未提交时,都是有锁的,对所有的写操作,加了持续的写锁,直到事务结束才释放。

因此,读未提交更合理的加锁策略是:
在写时加持续的写锁,阻塞其他事务的写,但不阻塞读,而读事务则没有任何锁。
将读未提交的加锁策略修改正确以后,以上这些策略就是标准的基于锁的隔离级别的实现。(虽然具体实现肯定很复杂,但是,其基本思路我们其实也完全有能力想明白,哈哈哈)
这四种不同的加锁策略实际上又称为 封锁协议(Locking Protocol),所谓协议,就是说不论加锁还是释放锁都得按照特定的规则来。读未提交 的加锁策略又称为 一级封锁协议,后面的分别是二级,三级,序列化 的加锁策略又称为 四级封锁协议。
多版本并发控制
锁可以用来做并发控制,但锁也存在一些缺陷,那就是,假如要实现读已提交,这已经可以算是最基本的能用的隔离级别了,也仍然不允许并发读写,特别是写操作直接要阻塞所有的读,当读写都很频繁时,数据库的并发性能将受到很大的影响,而假如要实现 RR 级别的隔离,那甚至读时还会阻塞写,性能下滑会更加严重。
针对这种场景的优化,就出现了大家耳熟能详的”多版本并发控制”。这相当于锁机制的一次升级。
普通锁:不能并发读,也不能并发写
读写锁:不能并发读写、不能并发写,但可以并发读
多版本并发控制:可以并发读写。
何谓多版本?根据维基百科
MVCC意图解决读写锁造成的多个、长时间的读操作饿死写操作问题。每个事务读到的数据项都是一个历史快照(snapshot)并依赖于实现的隔离级别。写操作不覆盖已有数据项,而是创建一个新的版本,直至所在操作提交时才变为可见。快照隔离使得每个事务看到的都是它查询时的数据状态。
再详细解释一下,每当一个事务要修改数据时,就复制一份要修改的数据,修改在原记录上进行,但其他事务的读则读复制出来的版本。每一份复制出来的数据(以及原数据)都有一个单向递增的版本号(相当于对事务中的查询操作开始时的数据库状态打了一个快照)。这样,写就不会阻塞读,因为读到的是不会被修改的副本,也就不需要加锁。在 mysql 中,使用单向递增的事务号来标注数据的版本。
我们来模拟一下双事务并发写时可能发生的情况。
自己想的实现
某数据 A,现存版本号为 T1(上一个修改的事务号),事务T2要修改数据时,将该数据复制一份,复制出来的版本号为 T1,原始数据也为 T1,此时事务 T3 开始,我们限制它只能读到版本号小于 T3 的数据,那么,也就是说,它最多读到 T2 的数据。但此时此刻,因为 T2尚未修改数据,所以 T3 读到的版本号是 T1,此时,T2 修改了数据并已提交,那么 T3 读到的版本应该是什么呢?显然,根据要隔离级别的不同,这里的结果应该不同。如果是读未提交,那实际上 T3 应该随时能读到 T2 的修改(数据的最新版本),此时,显然不应该用多版本并发控制(实际上读未提交时确实没有 MVCC 的事儿);但如果是读已提交,那此时应该读到 T2 已提交的修改;但此时如果是可重复读,那就应该始终读到 T1 这个版本。
不知道读到这里,大家有没有发现,我上面的黑体字其实是错误的。因为,假如 T3 开始后,T4 立即开启,而且 T4 修改了数据并提交,那么,在读已提交的隔离级别下,难道 T3 不能读取版本号为 T4 的数据。显然,根据读已提交的概念,并非如此。所以,上述限制其实并不存在。
也就是说,事务能读到什么版本的数据,和版本号大小其实没有关联。那么到底和什么有关联呢?我们先来自己想一下实现。
- 读已提交隔离级别下
我们把上面说的 T4 的情况代入,则可以画出图如下(注意这是读已提交的需求,而且这是我们假设需要自己实现时,我们简单思考应该怎么实现,并非 mysql 的标准实现):

我们发现,在读已提交的隔离级别下,我们只需要在写时对原始数据加持续写锁,并同时复制一份新的数据出来供其他事务读就可以了,这样,其他任何读事务在当前事务的修改未提交时,都读最新副本,当已提交时,副本干掉,就读原始数据。在我们这样的极简模型中,总是只需要一份冗余数据就可以了,因为同时写的只能是一个事务,由该事务维护快照,而其他事务尝试写的全部等待(写写总是不能并发的),尝试读的总是能读到快照即可。(注意,这并非 mysql 的实现)
-
可重复读隔离级别下
可重复读的含义是,一个事务总是只能看到自己事务开始之前的数据,之后对数据的修改,即使已提交,对该事务也都不可见。
那么,我们引入之前 T2、T3、T4并行时可能发生的情况

我们可以看到,我们只保存一个原始数据和一份不加锁的原始数据复制版是不够的,而是要维护一个版本号的链表。这里我们遇到了更多的问题:
- 既然现在数据旧版本形成了一个版本链,一个事务怎么知道自己要查询哪个版本的数据?
思考过程:
总是查询链表中比自己事务号小的最大的事务号对应的数据,可不可以?这样不可以,我们上面已经论述过了,一个事务对某个版本数据的可见性,与事务号大小并无直接关联,这里我们再重复一遍这个思考过程:以我们上面的图为例,假如 T2 开始后,T3 开始,此时 T2 尚未修改数据提交,那么 T3 应该一直看到 T1 的版本,而 T2 提交以后,T2 的版本号虽然是小于 T3 的最大的版本号,但仍不能被 T3 可见。甚至,T4 可能在 T3 查询以前,就已经提交了一个对数据的修改,T3 查询时,应该查到 T4 的数据。所以我们这里得出一个结论:一个事务可以看到哪些数据,不能通过当前事务号与版本号的对比确定。那应该通过哪些数据来确定呢?我们再来仔细思考一下。一个查询发生后,第二次查询发生前,该数据到底可能被哪些事务改动呢?只有两种,一种是第一次查询时还在活跃的事务,一种是在第一次查询以后创建的事务。那我们只要在版本链上,把这些事务做出的变更(带有这些事务号版本的数据)给忽略掉,就能找到我们第一次查询时应当看到的版本了。
那么,显然,当查询开始时,我们应当保存两种数据:查询发生时所有活跃事务的事务号快照active_tx_ids[];查询发生时系统已分配的最大的事务号 max_tx_Id,我们用这两个数据,结合数据版本链,就可以找到第一次查询时可见的版本号。那么,具体查询过程是怎么样的呢?我们继续思考:
我们假设此时此刻,数据链的版本号是这样的
T1 -> T7 -> T4,其中 T1、T7 已经提交,而 T4 还处于活跃状态,而 T5 此时也处于活跃状态,而且也想修改数据,但因为 T4 加了排他写锁,所以他在锁上等待。此时,T2 开始了自己的第一次查询,那么,它得到的活跃事务号是 T4、T5,当前最大的已分配事务号就是 T7,T2 拿到 T4 版本,发现该版本的事务号在活跃事务列表里,不要,拿到 T7,一看,是我们需要的数据,返回;而此时,T4 commit,T5因而立即获得锁,而数据链的版本号被改成:
T1 -> T7 -> T4 -> T5,此时 T2 开始了自己的第二次查询,拿到 T5 T4,发现在活跃事务链表里,不要,查到 T7,发现 T7 是想要的数据,返回。此时,T5 commit,T8 开始修改该数据,则数据链版本号变成了:
T1 -> T7 -> T4 -> T5 -> T8,此时 T2 开始了自己的第三次查询,拿到 T8,发现是查询之后才新建的事务,不要,查到 T5,T4,发现在活跃事务链表里,不要,查到 T7,返回。此时,T8 commit,T2 自己修改了该数据,则数据版本链变成了:
T1 -> T7 -> T4 -> T5 -> T8 -> T2,此时 T2 开始自己的第四次查询,拿到 T2,发现是自己的修改,显然应该要这个版本,返回。所以,我们写出伪代码,就成了这样:
do {
 if (tx_id == current_tx_id){
   return tx_id;
 } else if (tx_id > max_tx_id) {
    tx_id = tx_id -> pre_tx_id; // 该版本是查询开始后才开启的事务生成的,需要向前查
 } else if (tx_id in active_tx_ids){
   tx_id = tx_id -> pre_tx_id;  // 该版本是查询时尚未提交的事务生成的,需要向前查
 } else {
   return tx_id;
 }
} while (true);
于是第一个问题解决了。其实,这大概也就是 Mysql 的解决方案了(但其实还不太一致),mysql 将事务查询时保存的那些数据,称之为 Read View。
-
版本链什么时候清理,怎么清理。
我们不可能维护一个无限长的版本链,因此,版本链必须要清理,那版本链在什么时候清理呢?粗略地想一下,给个描述性的结论,那就是:在不再有活跃的事务需要该版本时,该版本就可以清理了。那什么叫不再有活跃的事务需要该版本呢?比如,上面的版本链,T1 其实早都该清理了,而在 T2 修改以后,T7 也可以不要了。然而这种描述性的结论太模糊,到底程序语言该怎么表达呢?
再思考一下,一个版本号只可能被当前正在活跃的事务需要,而需要的方式有这么几种:
- 一个事务正在修改该数据,这样的数据一定不能被清理;
-
虽然没有事务在修改该数据,但有事务正在查询该数据,或历史上查询过该数据且事务还未结束。而其实正在查询该数据、和历史上查询过该数据且事务未结束,其实本质上是一样的,都是”有活跃事务查询了该数据”。
那怎么判断有活跃事务查询了该数据呢?我们上面说到,线程第一次查询时会记录一些数据,包括当前活跃事务,和当前已分配的最大事务 ID。现在,我们要准备清理一个数据版本链中不再被使用到的数据了,笨办法想一想,先把版本链拿出来,从最新数据顺链向前,拿到一个数据链中一条数据的 tx_id,查看所有的活跃事务,先来一次判断
-
假如 tx_id 在活跃事务中,那该数据不能删除,直接拿下一条;
-
tx_id 不在活跃事务中,再查所有活跃事务的 Read View 中的活跃事务数据(这些事务有些可能已经不再活跃),如果 tx_id 在这些事务中,那也不能删除,因为,可能当前活跃事务需要这条数据链上的上一条数据。
以上面的那个例子举例,当 T2 活跃时,T2 的持有的 Read View中的活跃事务有 T4,T5,而 T2 此时就需要 T7 数据,而 T7 数据恰好在 T4 版本的上一个,为了维护链的完整性,T4、T5 数据也不被删除(当然不是绝对不能删除,只是要删除的话判断很复杂,而且做链表指针变更,还得加锁……)。
-
所以,我们从新到旧,不断判断是否是 Read View 中活跃事务的上一条数据,当最后遍历完所有当前活跃事务(清理任务开始时的活跃事务),再保留这一条数据,之前的数据就可以清理掉了。
但遗憾的是,我没有找到 mysql 关于如何判定一个版本号可以清理的具体逻辑,官方文档只简单地说:有一个后台线程,称为 purge 线程,会清理不再用到的版本号。其他文章目前也没有找到详细的判断逻辑,先这样吧。
总结一下:
我们上面的方式可以在理论上满足使用,即:
假如读已提交,那就只需要保存一个原始数据,以及保存一个原始数据的最新副本,所有查询都查询该副本,而更改都在原始数据上进行,任何一个修改被提交后,删掉该副本。
假如可重复读,那就需要维护一个版本链,之后根据查询开始时的快照,来判断到底当前查询可见哪些数据。
但对于一个工业级的数据库,我们会发现这样的情况:每个连接(connection)有自己单独的事务隔离级别,可能在一个事务读已提交时,另一个事务是可重复读(mysql 允许这样),此时两个事务查询同一个数据,表现应当是不同的。这种问题怎么解决呢?
其实这个问题也好办,我们只需要把 Read View 的概念推广到读已提交就可以了。如果说:可重复读看到的数据,是第一次查询时,已经提交的最新数据,那么读已提交就是:每一次查询时,已经提交的最新数据。换言之,既然可重复读中的 Read View 概念可以保证查到那一次查询的最新已提交数据,那么,如果我每次查询时,都生成一个 Read View,而不是把第一次查询生成的 Read View 给之后所有的查询使用,这就是读已提交了,这样,我们就可以在一个底层实现上(版本链 + Read View)同时支持读已提交和可重复读。
mysql 的实现
老实说,之前虽然说是自己想的实现,但其实在此之前我已经看过一些介绍 mysql 官方实现的文章了,这些文章老给我一种没点透的感觉,而且我自己也不能完全顺着那些文章的思路想明白。所以只好按自己的思路重新梳理,分隔离级别去思考,在这个过程中,又反复阅读之前的文章,才得到了上面的思路呈现。所以,其实 mysql 的官方实现,和上面的思路已经非常接近了。
在 mysql 的实现中,InnoDB 会为每一行记录都增加几个隐藏的辅助字段:
- DB_TRX_ID
6byte,最近修改(修改/插入)事务ID:记录创建这条记录/最后一次修改该记录的事务ID -
DB_ROLL_PTR
7byte,回滚指针,指向这条记录的上一个版本(存储于rollback segment里) -
DB_ROW_ID(如果有显式主键或者非空唯一索引,则该列不会有)
6byte,隐含的自增ID(隐藏主键),如果数据表没有主键,InnoDB会自动以DB_ROW_ID产生一个聚簇索引 -
删除 flag
当记录被删除并不代表真的删除,而是删除flag变了
其中,DB_ROW_ID 与我们的场景无关,其中,事务 ID 是递增的,在实际应用中被当做版本号。而我们上面所说到的版本链,就是之前提到的 undo log。其实仔细想一下也知道,undo log 本来就要记录历史版本数据,那么为什么不合理利用呢。所以,Mysql 使用 undo log 作为版本链,具体是这样的:
- 事务 T2 开始,尝试修改数据 A,则事务 T2 对该行原始数据加排它锁,然后把该行数据复制到 undo log 中去,作为旧记录,之后,修改原始记录中的事务号(版本号)为 T2,将回滚指针指向复制到 undo log 中的那个数据行里面去,事务提交后,释放锁。则此时版本链成为这样:

-
事务 T3 开始,尝试修改数据 A,则事务 T3 对该行原始数据加排它锁,然后把这个记录复制到 undo log 中去,修改该原始记录的事务号为 T3,将回滚指针指向复制进去的数据,事务提交后,释放锁,则此时的版本链成为这样:

而任何时候,当我们去查询一个数据时,就使用 Read View,找到了原始数据,也就找到了版本链,然后继续我们刚才说的那个流程就可以了。但在查询数据时,mysql 用的不是我刚才写的伪代码的那种算法,mysql 的算法是:
设从版本链中取到的数据版本号为 tx_id ,read view 中,活跃事务 ID 的链表为 active_tx_ids[],其中最小活跃事务号为 min_active_tx_id,而当前已分配的最大版本号为 max_tx_id,则 mysql 的算法为:
do {
  if (tx_id < min_active_tx_id){    // 说明该版本是已提交事务生成的,数据可见
    return tx_id;
  } else if (tx_id > max_tx_id){    // 该版本是查询开始后的事务生成的,数据不可见
    tx_id = tx_id -> pre_tx_id;
  } else {
    if (tx_id in active_tx_ids){
      // 说明这个版本是未提交事务生成的,但仍然分为: 当前事务自己做出的修改,和其他事务做出的修改
      if (tx_id == this_tx_id){
        return tx_id;
      } else {
        tx_id = tx_id -> pre_tx_id;
      }
    } else {
      return tx_id;
    }
  }
} while (true);
而我之前写的伪代码其实可以覆盖这个逻辑。这个逻辑看起来更复杂,但为什么 mysql 决定使用这个逻辑?我猜测可能还是性能原因,即:把最可能的情况放在第一个 if 去完成,而我的那个 if 的第一个条件呢,一个事务修改了一个数据,然后再查这个数据,这种场景还是比较少见的,这就导致第一个 if 绝大多数情况都是废的。而相反,tx_id < min_active_tx_id 这个条件,可能是最常见的场景,把他们放在最前面。整体来讲,还是在性能上锱铢必较,尽量去减少系统的运算量。
在 MVCC 的实现中,mysql 提炼了两个概念,当前读和快照读:
- 快照读
是指总是去读取快照。在 RC 级别下,这个快照就是:检查原始数据是否可读(被活跃事务占用),可读就读,不可读就去读 undo log 里的第一条数据,而 RR 依次检查整个链,直到遇到符合要求的数据。
-
当前读
则永远要读最新的数据,即数据的原始副本。比如:
SELECT ... LOCK IN SHARE MODESELECT ... FOR UPDATEINSERT / UPDATE / DELETE这几个语句一定要读数据的原始副本,第一个语句会加读锁,阻塞写不阻塞读,第二、三都是加写锁。
mysql 的隔离级别与当前读、快照读的关系如下:

有趣的问题:MVCC 能避免幻读嘛?
既然我们知道了 MVCC 的实现,我其实会陷入疑惑,看起来,MVCC 似乎已经可以避免幻读了。幻读是什么?是事务A的两次范围查询过程中,事务B发生了插入/删除行为,从而导致 A 的两次查询的结果不同,就好像出现了幻觉,因此称为幻读。
那么,我们来模拟一下这个问题,在 RR 级别下,画图如下:

看起来,幻读不会发生的样子啊。莫非官方文档有问题?莫非间隙锁没有存在的必要?莫非大神比我还蠢?那显然不可能啊。所以,通过查询资料(该资料公司内网无法打开,可能是 IP 被该网站墙了),我发现了一个问题,就是我刚才模拟的是”快照读”的情况,快照读因为 read view 的存在,读到的永远是第一次查询时的一致性视图。那假如是当前读呢?根据上面解释,当前读一定读取最新的记录,而且都要加锁。为什么呢?因为要求当前读的场合,都是要更新数据的,所以,必须读取最新记录,也就不能使用 MVCC。为什么不能?我们来看这样的场景。数据 A 版本号为 T2,事务 T3 开始,事务 T4 开始,事务 T3 尝试修改数据 A,此时事务 T4 也尝试更新数据 A,因为 T3 加了排他写锁,而无法获得锁,只能等待,假如,假如 T4 使用了 MVCC(read view),那么,T4 的更新行为将不可能在最新记录上发生,因为按照 MVCC 使用 Read View 的方式,T3 是 T4 开始时的活跃事务,在查找时应当忽略这个版本,它一定是找到数据 A 的 T2 版本,但这样的话,我们之前说的,更新总是复制当前记录行,去构建数据版本链的行为就被破坏了。
至此破案,为什么 MVCC 不能避免幻读?其实 MVCC 可以避免快照读时发生幻读,但无法避免当前读出现幻读。因为当前读不关 MVCC 的事儿,假如我们使用导致当前读的语句,MVCC 就不能避免幻读(因为它根本没有被用到)。所以幻读还是只能用其他手段来避免,官方文档没问题,间隙锁还是有存在的空间,大神还是比我聪明……
锁的各种类型
说了这么多,已经出现了不少关于锁的概念了,但是为了之前隔离级别那一块的完整性,对于锁的整体性介绍被推到了现在。InnoDB 中可能使用到的各种锁。根据官方文档,锁如下:
- Shared and Exclusive Locks(共享锁和排它锁)
- Intention Locks(意向锁)
- Record Locks(记录锁,单个记录上的锁)
- Gap Locks(间隙锁,锁定一个范围,但不包括记录本身。GAP锁是为了防止幻读)
- Next-Key Locks(记录锁+间隙锁)
- Insert Intention Locks(插入意向锁)
- AUTO-INC Locks(自增锁,用于自增主键)
- Predicate Locks for Spatial Indexes(用于空间索引上的锁,空间索引与传统B+树索引不同,不管)
这些锁是根据不同的分类依据进行分类的,他们之间相互有重叠。因此接下来也未必完全按照这个目录逐一去讲。
表锁和行锁
表锁
表锁是 mysql server 层实现的,所有存储引擎均可使用,而行锁是 InnoDB 实现的。
一般来说,要执行 DDL 时,都是由 server 层直接加表锁。同时,也可以手动对整张表加锁。
表锁的加锁原理比较粗暴,就是所谓的一次封锁 技术,也就是说,我们在会话开始的地方使用 lock 命令将后面所有要用到的表加上锁,在锁释放之前,我们只能访问这些加锁的表,不能访问其他的表,最后通过 unlock tables 释放所有表锁。这样的好处是,不会发生死锁。但坏处显然是性能问题了。
锁的释放规则是:
- 使用 UNLOCK TABLES 语句可以显示释放表锁;
- 如果会话在持有表锁的情况下执行 LOCK TABLES 语句,将会释放该会话之前持有的锁;
- 如果会话在持有表锁的情况下执行 START TRANSACTION 或 BEGIN 开启一个事务,将会释放该会话之前持有的锁;
- 如果会话连接断开,将会释放该会话所有的锁。
行锁
表锁简单且不会死锁,但问题就是性能太差,因此,InnoDB 实现了行锁。行锁也有读锁、写锁。
根据上次的分享,我们知道 Mysql 的数据是直接存储在聚簇索引上的,那么这个行锁加在哪里?答案是:就加在聚簇索引上。假如通过二级索引查询,那么二级索引先加锁,加完以后聚簇索引加锁。比如说,执行下面的语句
mysql> update students set score = 100 where id = 49;
InnoDB 会在这个 49 的聚簇索引上加一把锁。
而假如:
mysql> update students set score = 100 where name = ‘Tom’;
InnoDB 会现在 name = ‘tom’ 这个二级索引上加写锁(多条记录命中就都加锁),之后再根据这个找到 id = 49 的聚簇索引,也加写锁。过程如下:

如果还记得上面 commit and buffer pool那个小节的图,我们可以发现,修改的逻辑其实不是在 InnoDB 里单独完成的,涉及一个与 mysql server 层交互的过程。就是先 server 层把数据从存储引擎查出来,存储引擎会在查询时对语句加锁后返回,之后 server 层更新数据,再调用存储引擎,把数据写入,之后发生我们熟悉的两阶段提交。这样,一条数据更新完毕。
结合这里的知识,假如更新多条数据呢?比如说:
mysql> update students set level = 3 where score >= 60;
它的执行过程是这样的

就是一条一条来。但是 InnoDB 会怎么加锁呢?一条一条加锁嘛?这似乎不太对。因为,假如我要在事务里更新 10 条数据,如果我一条一条加锁,那第一,我即将要加的锁可能被其他事务占用,导致获取失败,第二,就算其他事务更新完毕以后释放了锁,但我一个事务里的更新,被迫要受到其他事务的影响,这又算哪门子的 ACID?所以,真正的实现是,假如 mysql 想要通过二级索引一口气更新多条记录,那么 InnoDB 直接将二级索引和相关的所有聚簇索引全部锁掉(在 RR 级别下还有间隙锁),然后一条一条返回。要验证这个问题,我们尝试在数据库里做个操作。

那么,假如通过一个没有索引的字段进行更新呢?想必大家已经猜到了,如果没有索引,那就直接锁全表所有记录(RR 级别还要锁所有的间隙)。所以,update 至少要走二级索引,决不能在使用无索引字段做条件进行更新操作,当然了,索引区分度要高,根据 active 去更新,和锁表区别不是很大。
行锁的加锁遵循两段锁协议,指每个事务的执行可以分为两个阶段:生长阶段(加锁阶段)和衰退阶段(解锁阶段)。加锁阶段:在该阶段可以进行加锁操作。在对任何数据进行读操作之前要申请并获得S锁,在进行写操作之前要申请并获得X锁。加锁不成功,则事务进入等待状态,直到加锁成功才继续执行。解锁阶段:当事务释放了一个封锁以后,事务进入解锁阶段,在该阶段只能进行解锁操作不能再进行加锁操作。
行锁包括这么几种:next_key lock,gap_lock,record_lock,insert_intention lock。在后面再详细介绍。
读写锁
读锁就是所谓共享锁,写锁就是所谓排它锁。InnoDB 实现了行级的读写锁。
读写锁是比较容易理解的概念,因为我们在开发中都会用到。共享锁可以多事务持有,阻塞写不阻塞读,而排它锁只单事务持有,阻塞写并阻塞读(但是因为读使用了 MVCC,实际上并不会阻塞快照读,依然会阻塞当前读)
意向读写锁
表锁锁定了整张表,而行锁是锁定表中的某条记录,它们俩锁定的范围有交集,因此表锁和行锁之间是有冲突的。譬如某个表有 10000 条记录,其中有一条记录加了 X 锁,如果这个时候系统需要对该表加表锁,为了判断是否能加这个表锁,系统需要遍历表中的所有 10000 条记录,看看是不是某条记录被加锁,如果有锁,则不允许加表锁,显然这是很低效的一种方法,为了方便检测表锁和行锁的冲突,从而引入了意向锁。当事务试图读或写某一条记录时,会先在表上加上意向锁,然后才在要操作的记录上加上读锁或写锁。这样判断表中是否有记录加锁就很简单了,只要看下表上是否有意向锁就行了。
所以,关于意向锁有几个重要的方面需要提炼一下:
- 意向锁是表锁;
- 意向锁是为了避免加表锁时性能太差引入的;
- 意向锁与行锁不会冲突;
- 意向锁之间也不会冲突(换言之,意向读写锁都可重入)
- 意向锁与其他表锁可能有冲突。(毕竟它被设计出来就是为了快速知道表锁能不能加的)
所以,在官方文档里也列出了这样的矩阵,要注意的是,这里列出的,全部是表锁,再强调一次,意向锁和行锁不冲突
Table-level lock type compatibility is summarized in the following matrix.
XIXSISXConflict Conflict Conflict Conflict IXConflict Compatible Conflict Compatible SConflict Conflict Compatible Compatible ISConflict Compatible Compatible Compatible
自增锁(AUTO_INC)
这也是个有意思的锁,首先,它是表锁,当数据库存在自增列时,每次插入数据,数据库就会先为该表加AUTO_INC 锁,其他事务的插入阻塞,这样保证生成的自增列一定唯一。
- AUTO_INC 锁互不兼容,也就是说同一张表同时只允许有一个自增锁;
- 自增锁不遵循二段锁协议,它并不是事务结束时释放,而是在 INSERT 语句执行结束时释放,这样可以提高并发插入的性能。
- 自增值一旦分配了就会 +1,如果事务回滚,自增值也不会减回去,所以自增值可能会出现中断的情况。
早期的自增锁就是很粗暴的一个表级写锁,但表级写锁这玩意肯定不能随便加啊,所以后来 Mysql 对于这个进行了优化,优化过程我粘贴在这里,就不细说了,因为这是个相对独立的锁。
四种行锁
记录锁
记录锁就是我们普遍理解的行锁,就是我们上面所说的,锁住索引的那个锁。正如上所说,请尽力避免使用一个非索引列作为条件来 update,因为这样会在所有数据上加表锁(但实际上 mysql 并不会在整个事务中一直加锁,而是使用了一个 trick,就是当 server 层过滤(fiter,还记得 explain 的那个 filter 字段吧)完毕后,就调用 InnoDB 的一个 unlock_row 的接口,把不满足条件的记录上的锁都释放掉,这样其他事务对这些记录的更新就不用等待了)(这显然违反了两段锁协议,但是性能好呗……)
间隙锁
间隙锁也叫范围锁、gap lock
可能大家都听过一句话,mysql 在可重复读的隔离级别下,实现了避免幻读。而在 SQL 的标准隔离级别下,可重复读隔离级别不能避免幻读。我们之前也论述过,MVCC 在当前读的情况下用不到,所以无法避免幻读。因此,假如要干掉幻读,就必须通过其他手段来完成。这就是间隙锁。那么何谓间隙锁?
正如其名,间隙锁是一种加在间隙之间的锁,什么的间隙?索引的间隙。或者加在第一个索引之前,或者加在最后一个索引之后(第一个和最后一个的含义是,二级索引可能命中多个),这个范围可能跨越一个索引记录、多个索引记录,也有可能是空的。当一个索引的间隙被锁住以后,所有尝试在对该间隙里数据进行修改的行为,包括:
- 插入新数据到该间隙;
- 从该间隙删除数据;
- 把已存在数据修改到该间隙内;
- 把已存在数据从该间隙内移出;
- 修改间隙内记录的任何字段;
(网上有说法和我不一致的,我可以负责任地说,mysql 5.7 版本的文章,只要对间隙锁的解读和我不一致,都是错的~)网上甚至还有把普通的 select 也拿来举例 gap 锁的,都是对 gap 锁理解不够深入。
mysql 只有在 RR 级别下才启用间隙锁(不知道大家发现没有,读已提交和可重复读这两个概念本身就是冲突的)
那么间隙锁到底是怎么加的呢?一个间隙其实只是一个不存在的东西,是一个空洞,我们怎样对一个空洞加锁呢?根据薅理睿羊毛得到的文档,我发现,原来锁是这么加的:
我们说
MySQL在REPEATABLE READ隔离级别下是可以解决幻读问题的,解决方案有两种,可以使用MVCC方案解决,也可以采用加锁方案解决。但是在使用加锁方案解决时有个大问题,就是事务在第一次执行读取操作时,那些幻影记录尚不存在,我们无法给这些幻影记录加上正经记录锁。不过这难不倒设计InnoDB的大叔,他们提出了一种称之为Gap Locks的锁,官方的类型名称为:LOCK_GAP,我们也可以简称为gap锁。比方说我们把number值为8的那条记录加一个gap锁的示意图如下:
如图中为
number值为8的记录加了gap锁,意味着不允许别的事务在number值为8的记录前边的间隙插入新记录,其实就是number列的值(3, 8)这个区间的新记录是不允许立即插入的。比方说有另外一个事务再想插入一条number值为4的新记录,它定位到该条新记录的下一条记录的number值为8,而这条记录上又有一个gap锁,所以就会阻塞插入操作,直到拥有这个gap锁的事务提交了之后,number列的值在区间(3, 8)中的新记录才可以被插入。

所以,称 gap 锁为一个”行锁”的确是实至名归。而且 gap 锁是加在后一个索引上的,指这个索引之前、直到上一个索引间隙,都不允许插入值。
那么我们再来刨根问底一下,抛出一个问题,大家来思考一下。我现在有这么一个数据库

id就是主键,c2 上建了二级索引。此时在两个 session 里顺序执行这样的语句。那么,现在的索引状况我帮大家画一下:

-- session 1;
start transaction;
select * from test_gap_lock where c2 = 'h' for update;

-- session 2;
insert into test_gap_lock (id, c2) values (2,'i');

-- session 3;
insert into test_gap_lock (id, c2) values (39, 'j') ;

-- session 4;
insert into test_gap_lock (id, c2) values (12, 'f');

-- session 5;
insert into test_gap_lock (id, c2) values (41, 'j');

-- session 6;
insert into test_gap_lock (id, c2) values (21, 'f');
这里加一副没用的图,免得太快翻到答案。

好吧,其实上面的二级索引是错误的,所以基于上述索引试图来思考间隙锁的问题,都是瞎猜,而真实的二级索引,一定会带一个聚簇索引~所以,其实这张表的二级索引是这样的(感谢这篇文章)(顺便把能否插入画出来了,红色在间隙中,不能插入,绿色不在间隙中,可以插入):

这时候还有一个问题,就是假如我要更新 (l, 50) 这个索引,那怎么锁住 50 之后的空间呢?因为后面没索引了呀~其实 InnoDB 为每一个索引都建立了一个虚拟的记录值,即:最小(Infimum)和最大(supremum)记录。锁这个就可以了。
最后一个提醒,上面说到,假如使用一个没有索引的列作为搜索条件来更新,那么不仅会锁住全表的记录,而且会锁住全表的间隙总之就是一个爽歪歪。最好不要这么做。
next-key lock
我们发现,当使用二级索引、或者范围查询聚簇索引以更新、删除时,都会使用间隙锁,而且,同时还要使用记录锁。这两个锁同时出现的概率相当之高。不如把这俩锁搞到一起,可行吗?
可行,这就是 next-key lock。它指的是加在某条记录(索引)上的记录锁以及这条记录前面间隙上的锁。next-key 锁住的是一个前开后闭区间,比如上面的例子,(32, ‘h’) 这个记录上的 next-key 锁,就会锁住( 30h, 32h ]这个范围。为什么是前开后闭呢?我们可以看前面 gap 锁加锁的那里,它就是加在后面一个记录(索引)上的,表示”封锁该索引之前的间隙”,本来是个开开区间,但是~此时又锁住了记录本身,就自然变成了开闭区间。为啥 gap 锁要锁前面不锁后面?其实是一样的,锁后面也行,随便选了一个。
next-key 是 RR 级别默认锁粒度,几乎所有的写锁都是这个粒度。但有时候假如是等值 update 唯一索引,会退化成记录锁,比如update tbl set c1 = 'zp' where id = 5,因为 id 是唯一索引,所以没必要锁间隙。
插入意向锁
间隙锁的概念说明白了,那么问题又来了。当我要插入数据时,我怎么知道要插入的那个数据是不是和间隙锁冲突了呢?莫非我也去获得间隙锁,可间隙锁之间是不冲突的啊,就算你让我去检查间隙锁是否存在,那我在插入的过程中,如果我本身不加点什么锁,那其他事务怎么知道这个间隙里正在插入数据呢?
于是,这里搞了一个插入意向锁,也是加在某条索引上的,而插入意向锁和间隙锁是冲突的,当我们尝试往同一个索引上加插入意向锁时,假如此时该索引上还有间隙锁,则插入失败。同理,当我正在往某个间隙插入数据时,获取间隙锁的尝试也会失败。
要注意区分这里的插入意向锁和之前介绍的意向锁。插入意向锁是间隙锁的一种,插入意向锁之间不冲突、间隙锁之间也不冲突,插入意向锁只和间隙锁相互冲突。
观察 InnoDB 的锁状况
lock mode
(这一段是后补的),因为我试了一下观察锁日志,发现不介绍 lock mode 的话,后面的输出根本看不懂。
数据库月报:InnoDB 锁系统浅析(对数据库月报的文章,标题里的“浅”都是扯淡的,因为一上来就是 mysql 源码甩脸,紧接着就是 bit 位分析……)
MySQL 将锁分成两类:锁类型(lock_type)和锁模式(lock_mode)。锁类型描述的锁的粒度(表锁、行锁、意向锁),也可以说是把锁具体加在什么地方;而锁模式描述的是到底加的是什么锁,譬如读锁或写锁。锁模式通常是和锁类型结合使用的,锁模式在 MySQL 的源码中定义如下:
/* Basic lock modes */
enum lock_mode {
  LOCK_IS = 0,    /* intention shared */
  LOCK_IX,    /* intention exclusive */
  LOCK_S,     /* shared */
  LOCK_X,     /* exclusive */
  LOCK_AUTO_INC,  /* locks the auto-inc counter of a table in an exclusive mode */
  LOCK_NONE,  /* this is used elsewhere to note consistent read */
  LOCK_NUM = LOCK_NONE, /* number of lock modes */
  LOCK_NONE_UNSET = 255
};
#define LOCK_MODE_MASK 0xFUL /* mask used to extact lock type from the type_mode field in a lock*/
在 Innodb 内部用一个 unsiged long 类型数据表示锁的类型, 如图所示,最低的 4 个 bit 表示 lock_mode, 5-8 bit 表示 lock_type, 剩下的高位 bit 表示行锁的类型。
record_lock type lock_type lock_mode lock_type 占用 5-8 bit 位,目前只用了第 5 和第 6 位,表示 LOCK_TABLE 和 LOCK_REC,使用宏定义
#define LOCK_TYPE_MASK 0xF0UL来获取值。record_lock_type 对于 LOCK_TABLE 类型来说都是空的,对于 LOCK_REC 目前值有:
#define LOCK_WAIT   256       /* 表示正在等待锁 */
#define LOCK_ORDINARY 0   /* 表示 next-key lock ,锁住记录本身和记录之前的 gap*/
#define LOCK_GAP    512       /* 表示锁住记录之前 gap(不锁记录本身) */
#define LOCK_REC_NOT_GAP 1024 /* 表示锁住记录本身,不锁记录前面的 gap */
#define LOCK_INSERT_INTENTION 2048    /* 插入意向锁 */
#define LOCK_CONV_BY_OTHER 4096       /* 表示锁是由其它事务创建的(比如隐式锁转换) */
大概了解一下就行了~其中LOCK_ORDINARY就是next-key lock,而LOCK_REC_NOT_GAP就是记录锁。他们都是写锁。
观察开始
那么,我们怎么观察 InnoDB 的锁状况呢?
首先,需要打开两个开关,使 InnoDB 在输出时输出锁数据。
set global innodb_status_output = ON;
set global innodb_status_output_locks = ON;
之后,有两个语句可以帮助我们观察锁消息。
select * from information_schema.innodb_locks;
show engine innodb status;
实测,第一个语句好像只有锁等待之类的场景才能显示出来数据,而第二个语句可以显示 InnoDB 的所有锁数据。
我们来执行这样的语句看一下(还是间隙锁的那个例子,注意,还是 RR 级别。因为 RC 级别不会有间隙锁):
start transaction;
select * from test_gap_lock where c2 = 'h' for update;
首先我们来分析一下,这个语句,因为是select ... for update,所以首先要对索引等于 h 的记录加记录锁,之后,还要对所有索引等于 h 的记录加间隙锁(这俩锁合并为 next-key lock)所以,是 3 个 next_key lock,另外,还需要对(40, ‘j’)的索引加间隙锁,另外,还有表意向写锁,所以,理论上此时应该有 5 把锁。我们来看一下
show engine innodb status;
// 忽略前后无关数据
------------
TRANSACTIONS
------------
Trx id counter 13432
Purge done for trx's n:o < 13429 undo n:o < 0 state: running but idle
History list length 0
LIST OF TRANSACTIONS FOR EACH SESSION:
---TRANSACTION 421668369933760, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 421668369932840, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 421668369931000, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 421668369930080, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 13431, ACTIVE 33 sec
4 lock struct(s), heap size 1136, 7 row lock(s)
MySQL thread id 67, OS thread handle 140193038997248, query id 21733 172.17.0.1 root

// 在这里找到了表意向写锁~~这样其他尝试加表级锁的行为就会失败
TABLE LOCK table `mt_db`.`test_gap_lock` trx id 13431 lock mode IX

// 找到了写锁,这是加在 h 的索引上的。注意这里,lock_mode x,就是指 next-key 锁
// 所以三个 next-key 找到了
RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13431 lock_mode X
// 观察下面的锁信息,这里显示加了一个记录锁,锁住了 h,锁有两部分,第一部分是 h,第二部分去除打头的 8,就是 30)
Record lock, heap no 5 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 800000000000001e; asc         ;;

// 一个记录锁,锁住了 h,锁有两部分,第一部分是 h,第二部分去除打头的 8,就是 11)
Record lock, heap no 8 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 800000000000000b; asc         ;;

// 一个记录锁,锁住了 h,锁有两部分,第一部分是 h,第二部分去除打头的 8,就是 32)
Record lock, heap no 9 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 8000000000000020; asc         ;;

RECORD LOCKS space id 136 page no 3 n bits 80 index PRIMARY of table `mt_db`.`test_gap_lock` trx id 13431 lock_mode X locks rec but not gap  // 虽然是 lock mode x,但注明不锁 gap,所以是记录锁

// 这是主键锁,有三把主键锁,这里锁住 30 的主键
Record lock, heap no 5 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 800000000000001e; asc         ;;
 1: len 6; hex 000000003455; asc     4U;;
 2: len 7; hex ed000001ed0143; asc       C;;
 3: len 10; hex 68202020202020202020; asc h         ;;

// 这是主键锁,有三把主键锁,这里锁住 11 的主键
Record lock, heap no 8 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 800000000000000b; asc         ;;
 1: len 6; hex 00000000345e; asc     4^;;
 2: len 7; hex f2000001870110; asc        ;;
 3: len 10; hex 68202020202020202020; asc h         ;;

// 这是主键锁,有三把主键锁,这里锁住 32 的主键。
Record lock, heap no 9 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 8000000000000020; asc         ;;
 1: len 6; hex 00000000345e; asc     4^;;
 2: len 7; hex f2000001870121; asc       !;;
 3: len 10; hex 68202020202020202020; asc h         ;;

// 在 j 40 上加了一个间隙锁
RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13431 lock_mode X locks gap before rec // 直接写明了是间隙锁
Record lock, heap no 6 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 6a202020202020202020; asc j         ;;
 1: len 8; hex 8000000000000028; asc        (;;
所以,好吧……我遗漏了三个主键锁……忘了锁定其实是一并锁聚簇索引的了。
那么,假如,此时我再尝试加入一个锁等待行为,这里输出会变成啥样呢?比如,在刚才那个事务没完成时,尝试执行
insert into test_gap_lock (id, c2) values (2,'i');
输出变成了这样:
------------
TRANSACTIONS
------------
Trx id counter 13434
Purge done for trx's n:o < 13429 undo n:o < 0 state: running but idle
History list length 0
LIST OF TRANSACTIONS FOR EACH SESSION:
---TRANSACTION 421668369933760, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 421668369931000, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 421668369930080, not started
0 lock struct(s), heap size 1136, 0 row lock(s)
---TRANSACTION 13433, ACTIVE 4 sec inserting
// 这里出现了锁等待
mysql tables in use 1, locked 1
LOCK WAIT 2 lock struct(s), heap size 1136, 1 row lock(s), undo log entries 1
MySQL thread id 68, OS thread handle 140193038456576, query id 21888 172.17.0.1 root update
/* ApplicationName=DataGrip 2021.1.1 */ insert into test_gap_lock (id,c2) values (2,'i')
------- TRX HAS BEEN WAITING 4 SEC FOR THIS LOCK TO BE GRANTED:
// 显示插入意向锁阻塞了,阻塞在哪里了呢?阻塞在 40 j 这个索引的间隙锁上了。
RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13433 lock_mode X locks gap before rec insert intention waiting
Record lock, heap no 6 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 6a202020202020202020; asc j         ;;
 1: len 8; hex 8000000000000028; asc        (;;

------------------
TABLE LOCK table `mt_db`.`test_gap_lock` trx id 13433 lock mode IX
RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13433 lock_mode X locks gap before rec insert intention waiting
Record lock, heap no 6 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 6a202020202020202020; asc j         ;;
 1: len 8; hex 8000000000000028; asc        (;;

// 下面是一样的
---TRANSACTION 13432, ACTIVE 11 sec
4 lock struct(s), heap size 1136, 7 row lock(s)
MySQL thread id 67, OS thread handle 140193038997248, query id 21864 172.17.0.1 root
TABLE LOCK table `mt_db`.`test_gap_lock` trx id 13432 lock mode IX
RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13432 lock_mode X
Record lock, heap no 5 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 800000000000001e; asc         ;;

Record lock, heap no 8 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 800000000000000b; asc         ;;

Record lock, heap no 9 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 68202020202020202020; asc h         ;;
 1: len 8; hex 8000000000000020; asc         ;;

RECORD LOCKS space id 136 page no 3 n bits 80 index PRIMARY of table `mt_db`.`test_gap_lock` trx id 13432 lock_mode X locks rec but not gap
Record lock, heap no 5 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 800000000000001e; asc         ;;
 1: len 6; hex 000000003455; asc     4U;;
 2: len 7; hex ed000001ed0143; asc       C;;
 3: len 10; hex 68202020202020202020; asc h         ;;

Record lock, heap no 8 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 800000000000000b; asc         ;;
 1: len 6; hex 00000000345e; asc     4^;;
 2: len 7; hex f2000001870110; asc        ;;
 3: len 10; hex 68202020202020202020; asc h         ;;

Record lock, heap no 9 PHYSICAL RECORD: n_fields 4; compact format; info bits 0
 0: len 8; hex 8000000000000020; asc         ;;
 1: len 6; hex 00000000345e; asc     4^;;
 2: len 7; hex f2000001870121; asc       !;;
 3: len 10; hex 68202020202020202020; asc h         ;;

RECORD LOCKS space id 136 page no 4 n bits 80 index test_gap_lock_c2_index of table `mt_db`.`test_gap_lock` trx id 13432 lock_mode X locks gap before rec
Record lock, heap no 6 PHYSICAL RECORD: n_fields 2; compact format; info bits 0
 0: len 10; hex 6a202020202020202020; asc j         ;;
 1: len 8; hex 8000000000000028; asc        (;;
死锁日志其实也是这个样子,我们可以利用这个日志来分析死锁(下次找个例子分析一下)
提交覆盖问题:业务级别的锁
锁的类型介绍到这里也就差不多了,接下来还有个问题没有解决,我们使劲往上翻,可见即使 mysql 在 RR级别下解决了幻读问题,但提交覆盖的问题则仍然没有解决。
| 隔离级别 | 回滚覆盖 | 脏读 | 不可重复读 | 提交覆盖 | 幻读 |
|---|---|---|---|---|---|
| 读未提交 | ❌ | ✔️ | ✔️ | ✔️ | ✔️ |
| 读已提交 | ❌ | ❌ | ✔️ | ✔️ | ✔️ |
| 可重复读 | ❌ | ❌ | ❌ | ✔️ | ❌ |
| 序列化 | ❌ | ❌ | ❌ | ❌ | ❌ |
对于这种问题,只能从业务方面想其他办法去解决。怎么解决呢?我们再还原一下丢失更新的场景。
T1 查询了一个数据,此时可能是快照读或者当前读,select 没有特殊子句时,都是快照读。查出余额 1000
T2 查询了一个数据,也认为是快照读。查出余额 1000
T1 利用查询出来的数据,更新了该条记录,比如,把查询出来的数据账户余额加 100。
T2 利用查询出来的数据,更新了该条记录,比如,把查询出来的账户余额 -100,因为 T1 已经获得写锁,T2 锁等待。
T1 提交,账户余额变成了 1100;
T2 获得锁,将该账户余额改为 900,提交。
此时,T1 的更新被覆盖丢失了。这就是覆盖丢失。
那么要怎么解决这个问题呢?其实很简单,这俩线程在第一次查询时,都直接尝试select ... for update;,直接给数据加写锁,写锁会阻塞当前读,这样另一个线程在查询那一步就阻塞了,这样等到他能读时,已经是提交后的数据了,这样就解决了更新覆盖问题,相当于在这个行上面强行序列化相关事务。
这当然是一种方法,这种方式假设更新一定会发生冲突,所以在更新前就加锁,这样避免了所有可能的冲突。但加锁和释放锁是有单独消耗的,而且在查询时就加锁,也延长了加锁的时间,假如说我这个数据库的更新频率不是很高(发生冲突的概率很低),那这种加锁和释放锁,就是可耻的浪费。所以,这里又提出了另外一种锁思想,就是所谓的版本号方法。即,在数据上加一个版本行,每次更新时都原子地更新这个版本号,并且更新时要求版本号和上次查出来的版本号相同,大概类似这样的语句:
update tbl set c1 = xx, c2 = xx, version = version + 1 where condition and version = old_version
这样,在上面的情况里,T1 查询数据,查出版本号是 1,T2 查询数据,版本号也是 1,T1 更新数据,版本号会被改成 2,而 T2 更新数据时,发现版本号不匹配,就会出错。
这就是:假设更新时不会发生冲突,只有在真发生冲突以后再处理,处理方法就是重新来一遍整个查询、更新的流程。这样,在锁竞争不激烈的场合,这样有效减少了加锁的时间,所以性能会好。
很显然,这就是经典的 悲观锁 和 乐观锁 概念,广泛用于编程中,Java 中的 CAS(Compare And Set),也是乐观锁思想的实践。所以也和经典悲观锁、乐观锁一样,有各自适用场合,如果竞争真的很激烈,那么悲观锁性能更好,因为乐观锁会导致反复反复反复重试,而如果竞争不激烈,乐观锁因为省去了加锁、解锁时间并减少了锁定时间,所以乐观锁性能好。(在 mysql 的场合,其实 update 语句那一句是无法省去加锁、解锁过程的,但是它减少了加锁时间,所以性能也会变好)(JPA 有个@Version的注解,帮助我们实现了乐观锁。)
小结和下期预告
这一次分享,主要还是介绍事务和锁。
事务是什么?我个人理解,事务就是一系列有关联的数据库操作,因为要在业务上保证 ACID,而被数据库抽象成一个原子的概念,称为事务。
但是,假如要完全正确地保证每一条事务的 ACID 特性,那么,只能让所有的事务执行序列化操作,甚至说,我们在上层应用上加锁(在多应用访问数据库时,这难度很高甚至不可能),但这样一来,数据库的并发性能就很差,无法支持高并发的读写。因此,为了性能而允许牺牲一定的 ACID 特性,SQL 标准提出了事务的隔离级别这个概念。在不同的隔离级别下,可能出现不同的数据安全性问题,比如脏读、不可重复读、幻读、提交覆盖等等。
有时候,经过业务评估,我们认为可能我们不会出现引发幻读和不可重复读的场景,那我们就可以放心使用 RC 级别。在大多数时候,使用默认级别也不错(mysql 的默认隔离级别是 RR)
而锁就是用来辅助实现隔离级别的,锁只是工具,重要的是隔离级别的实现。所以,因为锁的性能问题,绝大多数数据库都实现了 MVCC,和锁配合,解决了读写冲突问题,进一步提高了数据库并发性能。
为了不同的目的,数据库中存在各种各样的锁,我们对其进行了较为完整的介绍,并且用一个例子展示了如何查看 InnoDB 的加锁状况,希望对大家有所帮助。
在学习锁的过程中,我认为有一点需要始终牢记,那就是:锁是为隔离级别服务的。所以只要提到锁,就必须首先想到隔离级别,在不同的隔离级别下加的锁不一样,是因为需要实现的隔离级别不一样。脱离隔离级别去讨论锁,都是空中楼阁。当被问到什么什么锁时,应该首先反问,是什么隔离级别下的锁?比如,我们说写锁,在 RC 级别下,就是记录锁,而在 RR 级别下,就是 Next-key Lock,而在 RC 级别下谈 Gap 锁,就显然是对锁了解还不够全面。
我也是从一无所知,逐步摸索形成的这次分享内容(所以甚至主题都给改了),因此分享的重点,在于如何从概念上理解各种不同的锁,而对其具体实现,比如深入源码、bit 位之类的东西则没有介绍。因为,一来我认为我们并不需要再实现一遍 mysql,甚至不需要做类似的事情,而只是需要理解各种锁的概念,以辅助我们的开发、解决死锁问题等等,一来具体实现博大精深,十分复杂,一旦想要深入就深陷细节之中,难以窥其全貌。
这一节主要是介绍各种各样的锁,也提到了一些语句的加锁流程。但因为了解 mysql 的锁,不仅是为了学习其中的思想,更实际的作用是解决业务中的死锁问题、提高日常写 SQL 时的性能,所以下一次分享的话,我会逐个介绍 mysql 中的各种语句在不同隔离级别下可能引发的各种锁,以及拿业务中一个实际存在的死锁问题做一分析,尝试解开这个死锁问题发生原因。欢迎大家继续围观拍砖。
0 条评论