PAT甲级1041-1050
其中1047题通过率为0,目测应该是题目有问题。
1041 Be Unique
map大法
#include<iostream>
#include<vector>
#include<map>

using namespace std;

int main(){

    ios::sync_with_stdio(false);
    int N;
    cin >> N;
    vector<int> store(N);
    std::map<int,int> counts;
    for(int i = 0 ; i != N ; ++i){
        cin >> store[i];
        ++counts[store[i]];
    }
    for(int i = 0 ; i != N ; ++i){
        if (counts[store[i]] == 1){
            cout << store[i];
            return 0;
        }
    }
    cout << "None";
    return 0;

}
vector erase大法
//按理说这种解法在极端情况下效果很差,可能是这道题的测试节点不难,结果算下来都差不太多。
#include<vector>
#include<set>
#include<iostream>
#include<algorithm>

using namespace std;

int main(){

  ios::sync_with_stdio(false);
  vector<int> res;
  set<int> exists;
  int N;
  cin >> N;
  for(int i = 0 ; i != N ; ++i){
    int tmp;
    cin >> tmp;
    if (exists.find(tmp) == exists.end()){
      res.push_back(tmp);
      exists.insert(tmp);
    }else{
      auto it = find(res.begin(),res.end(),tmp);
      if (it != res.end())
        res.erase(it);
    }
  }
  if (res.empty()){
    cout << "None" << endl;
  }else{
    cout << res.front() << endl;
  }
  return 0;

}
1042 Shuffling Machine
#include <iostream>
#include <string>
#include <vector>

using namespace std;

string map(int a) {
  if (a <= 13) {
    return 'S' + to_string(a);
  } else if (a <= 26) {
    return 'H' + to_string(a - 13);
  } else if (a <= 39) {
    return 'C' + to_string(a - 26);
  } else if (a <= 52) {
    return 'D' + to_string(a - 39);
  } else {
    return 'J' + to_string(a - 52);
  }
}

int main() {

  ios::sync_with_stdio(false);
  int N;
  cin >> N;
  vector<int> order(55);
  for (int i = 1; i != 55; ++i) {
    cin >> order[i];
  }
  vector<int> initial(55);
  for (int i = 0; i != 55; ++i) {
    initial[i] = i;
  }
  vector<int> res(55);
  for (int i = 0; i != N; ++i) {
    for (int j = 1; j != 55; ++j) {
      res[order[j]] = initial[j];
    }
    initial = res;
  }

  for (int i = 1; i != 54; ++i) {
    cout << map(res[i]) << " ";
  }
  cout << map(res.back()) << endl;

  return 0;
}
1043 Is It a Binary Search Tree
//太复杂的解法又想不出来,只好暴力整着。判断是不是一个搜索树,就是看是不是左子树都小于根节点,
//并且右子树都大于根节点。

#include <iostream>
#include <vector>

using namespace std;

struct node {
  int data;
  node *left;
  node *right;
};

node *BST(const vector<int> &origin, int begin, int end) {

  if (begin > end) {
    return nullptr;
  }
  int head = origin[begin];
  int middle = -1;
  for (int i = begin + 1; i <= end; ++i) {
    if (origin[i] >= head) {
      middle = i;
      break;
    }
  }
  if (middle != -1) {
    //如果还等于-1说明右子树直接缺失了,全部都比节点小,只有左子树的意思
    for (int i = middle; i <= end; ++i) {
      if (origin[i] < head)
        return (node *)-1;
    }
  } else {
    middle = end + 1; //意思是让之后右子树返回一个nullptr
  }
  node *root = new node;
  root->data = head;
  root->left = BST(origin, begin + 1, middle - 1);
  root->right = BST(origin, middle, end);
  if (root->left == (node *)-1 || root->right == (node *)-1) {
    return (node *)-1;
  } else {
    return root;
  }
}

node *mirror_BST(const vector<int> &origin, int begin, int end) {

  if (begin > end) {
    return nullptr;
  }
  int head = origin[begin];
  int middle = -1;
  for (int i = begin + 1; i <= end; ++i) {
    if (origin[i] < head) {
      middle = i;
      break;
    }
  }
  if (middle != -1) {
    //等于-1说明右子树缺少了
    for (int i = middle; i <= end; ++i) {
      if (origin[i] >= head)
        return (node *)-1;
    }
  } else {
    middle = end + 1;
  }
  node *root = new node;
  root->data = head;
  root->left = mirror_BST(origin, begin + 1, middle - 1);
  root->right = mirror_BST(origin, middle, end);
  if (root->left == (node *)-1 || root->right == (node *)-1) {
    return (node *)-1;
  } else {
    return root;
  }
}

void post_travel(node *root, vector<int> &output) {

  if (root == nullptr) {
    return;
  }
  post_travel(root->left, output);
  post_travel(root->right, output);
  output.push_back(root->data);
}

void print_tree(const vector<int> &output) {

  cout << "YES" << endl;
  for (int i = 0; i != output.size() - 1; ++i) {
    cout << output[i] << " ";
  }
  cout << output.back() << endl;
  return;
}

int main() {

  ios::sync_with_stdio(false);
  int N;
  cin >> N;
  vector<int> origin(N);
  for (int i = 0; i != N; ++i) {
    cin >> origin[i];
  }

  node *root = BST(origin, 0, N - 1);
  vector<int> output;
  if (root != (node *)-1) {
    post_travel(root, output);
    print_tree(output);
    return 0;
  }
  root = mirror_BST(origin, 0, N - 1);
  if (root != (node *)-1) {
    post_travel(root, output);
    print_tree(output);
    return 0;
  }
  cout << "NO" << endl;
  return 0;
}
1044 Shopping in Mars
内存超限
//这道题实在也想不出更好的办法来,直接用二维数组存一套结果遍历吧。
//超时不超时已经没法知道了,因为数据规模一大,二维数组就内存超限了...

#include <iostream>
#include <vector>

using namespace std;

int main() {

  ios::sync_with_stdio(false);
  int N, should_pay;
  cin >> N >> should_pay;
  vector<int> chain(N + 1, 0);
  int min = 100000000;
  vector<vector<int>> money(N + 1, vector<int>(N + 1, 0));
  for (int i = 1; i != N + 1; ++i) {
    cin >> chain[i];
    money[i][i] = chain[i];
    money[0][i] = chain[i - 1] + money[0][i - 1];
  }
  for (int i = 1; i != N + 1; ++i) {
    for (int j = i; j != N + 1; ++j) {
      money[i][j] = money[i][j - 1] + chain[j];
      if (money[i][j] >= should_pay and money[i][j] < min) {
        min = money[i][j];
      }
    }
  }
  for (int i = 1; i != N + 1; ++i) {
    for (int j = i; j != N + 1; ++j) {
      if (money[i][j] == min) {
        cout << i << '-' << j << endl;
      }
    }
  }
  return 0;
}
运行超时
//刚开始想的办法是直接二维数组存结果,之后暴力求所有结果。
//但是对于10^5个int来说,需要40G的内存,这就显然扯淡了。
//再琢磨,其实上面的二维数组可以简化,如果用一个数组arr[i]来存储从1到i的数字和
//那么从i到j的数字和就是arr[j] - arr[i] + chain[i]
//然后那几个内存超限的节点全都超时了

#include <iostream>
#include <map>
#include <utility>
#include <vector>

using namespace std;

int main() {

  ios::sync_with_stdio(false);
  int N, should_pay;
  cin >> N >> should_pay;
  vector<int> chain(N + 1, 0);
  vector<int> money(N + 1, 0);
  int min = 100000000;
  map<int, vector<pair<int, int>>> output;
  for (int i = 1; i != N + 1; ++i) {
    cin >> chain[i];
    money[i] = money[i - 1] + chain[i];
  }
  for (int i = 1; i != N + 1; ++i) {
    for (int j = i; j != N + 1; ++j) {
      if (money[j] - money[i] + chain[i] == should_pay) {
        min = should_pay;
        cout << i << '-' << j << endl;
        break;
      } else if (money[j] - money[i] + chain[i] > should_pay and
                 money[j] - money[i] + chain[i] <= min) {
        min = money[j] - money[i] + chain[i];
        output[min].push_back({i, j});
      }
    }
  }
  if (min != should_pay) {
    for(int i = 0 ; i != output[min].size() ; ++i){
      cout << output[min][i].first << '-' << output[min][i].second << endl;
    }
  }
  return 0;
}
运行超时2
//超时的显然是那个超大循环。但是超大循环怎么优化呢?琢磨一下。
//如果用二分查找,应该要快一点。这样修改后,只有一个节点超时了

#include <iostream>
#include <utility>
#include <vector>

using namespace std;
#define INF 100000000

int find_index(const vector<int> &money, const vector<int> &chain,
               const int begin, int left, int right, const int should_pay) {
  if (left >= right)
    return right;

  int middle = (left + right) / 2;
  if (money[middle] - money[begin] + chain[begin] >= should_pay)
    return find_index(money, chain, begin, left, middle, should_pay);
  else
    return find_index(money, chain, begin, middle + 1, right, should_pay);
}

int main() {

  ios::sync_with_stdio(false);
  int N, should_pay;
  cin >> N >> should_pay;
  vector<int> chain(N + 1, 0);
  vector<int> money(N + 1, 0);
  int min = INF;
  vector<pair<int, int>> output;
  for (int i = 1; i != N + 1; ++i) {
    cin >> chain[i];
    money[i] = money[i - 1] + chain[i];
  }
  for (int i = 1; i != N + 1; ++i) {
    int j = find_index(money, chain, i, i, N, should_pay);
    if (money[j] - money[i] + chain[i] >= should_pay) {
      if (money[j] - money[i] + chain[i] == should_pay) {
        min = should_pay;
        cout << i << '-' << j << endl;
      } else if (money[j] - money[i] + chain[i] < min) {
        min = money[j] - money[i] + chain[i];
        output.clear();
        output.push_back({i, j});
      } else if (money[j] - money[i] + chain[i] == min) {
        output.push_back({i, j});
      }
    }else{
      //从这个i出发找到队列尾,也没找到能够支付的
      break;
    }
  }
  if (min != should_pay) {
    for (int i = 0; i != output.size(); ++i) {
      cout << output[i].first << '-' << output[i].second << endl;
    }
  }
  return 0;
}
AC代码
//把上面一道题全部换成cstdio,AC了,这是因为cout的效率仍然很低
//网上有大神提供
//setvbuf(stdin, new char[1 << 20], _IOFBF, 1 << 20);
//setvbuf(stdout, new char[1 << 20], _IOFBF, 1 << 20);
//这两段代码,看来就是给stdin和stdout设置了缓存,理论上有可能加速。但实际上这道题里并没有加速。

#include <cstdio>
#include <utility>
#include <vector>

using namespace std;
#define INF 100000000

int find_index(const vector<int> &money, const vector<int> &chain,
               const int begin, int left, int right, const int should_pay) {
  if (left >= right)
    return right;

  int middle = (left + right) / 2;
  if (money[middle] - money[begin] + chain[begin] >= should_pay)
    return find_index(money, chain, begin, left, middle, should_pay);
  else
    return find_index(money, chain, begin, middle + 1, right, should_pay);
}

int main() {

  int N, should_pay;
  //setvbuf(stdin, new char[1 << 20], _IOFBF, 1 << 20);
  //setvbuf(stdout, new char[1 << 20], _IOFBF, 1 << 20);
  scanf("%d %d",&N,&should_pay);
  vector<int> chain(N + 1, 0);
  vector<int> money(N + 1, 0);
  int min = INF;
  vector<pair<int, int>> output;
  for (int i = 1; i != N + 1; ++i) {
    scanf("%d",&chain[i]);
    money[i] = money[i - 1] + chain[i];
  }
  for (int i = 1; i != N + 1; ++i) {
    int j = find_index(money, chain, i, i, N, should_pay);
    if (money[j] - money[i] + chain[i] >= should_pay) {
      if (money[j] - money[i] + chain[i] == should_pay) {
        min = should_pay;
        printf("%d-%d\n",i,j);
      } else if (money[j] - money[i] + chain[i] < min) {
        min = money[j] - money[i] + chain[i];
        output.clear();
        output.push_back({i, j});
      } else if (money[j] - money[i] + chain[i] == min) {
        output.push_back({i, j});
      }
    }else{
      //从这个i出发找到队列尾,也没找到能够支付的
      break;
    }
  }
  if (min != should_pay) {
    for (int i = 0; i != output.size(); ++i) {
      printf("%d-%d\n",output[i].first , output[i].second);
    }
  }
  return 0;
}
1045 Favorite Color Stripe
最长公共子序列问题
感觉这道题像是最长公共子序列的加强版,那么首先回顾一下最长公共子序列是怎么搞的。
我们先考虑最长公共子序列的暴力解法,那就是把所有的可能子序列都找出来,然后对比。那么怎么穷举一个序列的子序列呢?
递归法
递归法和非递归法的思路是一样的,都是利用已经生成的子序列,再逐一将原序列中该子序列最后一个元素后面的元素一个一个接到该子序列上,作为新的子序列收集到结果集中。直到所有的结果都收集完毕即可。
在这个递归法里,指示子序列中最后一个元素的变量是pos。在这个算法里,是不断在一个子序列后面做添加,直到这个序列加无可加。
#include <iostream>
#include <vector>

using namespace std;

void get_child(const vector<int> &arr, const int size, int pos, vector<int> sub,
               vector<vector<int>> &res) {

  if (pos == size)
    return;
  vector<int> tmpsub = sub;
  for (int i = pos; i != size; ++i) {
    int tmp = arr[i];
    tmpsub.push_back(tmp);
    res.push_back(tmpsub);
    get_child(arr, size, i + 1, tmpsub, res);
    tmpsub = sub;
  }
}

int main() {

  int N;
  cin >> N;
  vector<int> arr(N);
  for (int i = 0; i != N; ++i)
    cin >> arr[i];

  vector<vector<int>> res;
  get_child(arr, N, 0, vector<int>(), res);
  for(int i = 0 ; i != res.size() ; ++i){
    for(auto it = res[i].begin() ; it != res[i].end() ; ++it){
      cout << *it << " ";
    }
    cout << endl;
  }
  return 0;
}
非递归法
这个算法和上面的核心思路一样,只不过他是根据长度不断做添加,首先将一个元素的子序列全部纳入结果集,再将这些元素取出来,在这些元素后面做添加,添加成两个元素的子序列,再对两个元素的子序列做加法。其中pair<vector<int>,int>中pair的第二个元素,就是指示这个子序列的尾部是哪一个元素。
#include <iostream>
#include <utility>
#include <vector>

using namespace std;

void get_child(const vector<int> &arr, const int size,
               vector<pair<vector<int>, int>> &res) {

  for (int i = 0; i != size; ++i) {
    res.push_back({{arr[i]}, i});
  }
  int begin = 0;
  int ressize = res.size();
  for (int len = 1; len != size; ++len) {
    for (int i = begin; i != ressize; ++i) {
      for (int j = res[i].second + 1; j < size; ++j) {
        res.push_back({res[i].first, j});
        res.back().first.push_back(arr[j]);
      }
    }
    begin = ressize;
    ressize = res.size();
  }
}

int main() {

  int N;
  cin >> N;
  vector<int> arr(N);
  for (int i = 0; i != N; ++i)
    cin >> arr[i];

  vector<pair<vector<int>, int>> res;
  get_child(arr, N, res);
  for(auto it = res.begin(); it != res.end() ; ++it){
    for (auto it2 = it->first.begin(); it2 != it->first.end(); ++it2) {
      cout << *it2 << " ";
    }
    cout << endl;
  }
  return 0;
}
两个求子序列的算法时间复杂度都是2^n,如果两个序列的长度分别是m和n,那么两两对比的时间复杂度就是2^{m+n},这就绝对不可接受了。不过有了暴力解法至少就有个思路,我们可以接下来考虑,造成这么高复杂度的原因是什么,里面有没有重复的子过程不断重复?
答案是有的,比如说在A序列里,我们取了某个从下标m_A到n_A的某个子序列childA[m_A-n_A],和B序列下标m_B到n_B之间的某个子序列childB[m_B-n_B]是相同的,且这恰好是他们的最大公共子序列,那么假设A[n_{A+1}] == B[n_{b+1}],那么显然childA[m_A-n_A] + A[n+1] 和childB[m_B-n_B]+B[n+1]也是相同的。但在上面的暴力解法中,已经比较过的childA和childB又比较了一次。
所以这就是可以优化的部分,这也是动态规划用空间换时间的思路的用武之地。我们的考虑是,假设A[0\~m]和B[0\~n]的最长公共子序列已经找到,为C[k],那么我们考虑,当A[m+1] == B[n+1]的时候,C[k+1]当然就已经找到了,那么而当A[m+1] != B[n+1]的时候,C[k+1]有可能等于A[m+1],这时候C[K+1]是A[m+1]和B[n]的最长公共子序列;C[k+1]也有可能等于B[n+1],这时候C[k+1]是A[m]和B[n+1]的最长公共子序列;或者直接C[k+1]既不等于A[m+1] ,也不等于B[n+1],那么只能说C[k]依旧A[m+1]和B[n+1]的最长公共子序列。
这样想的话,就有了下面的分析:
动态规划
假设有三个序列,a[0\~m]和b[0\~n]是需要求解的序列,c[0\~k]是a,b的最长公共子序列,令len[i][j]为a[0\~i]和b[0~j]的最长子序列长度,则有:
- 如果a[m] = b[n],则c[k]=a[m]=b[n],且c[0\~k-1]是a[0\~m-1]和b[0~n-1]的最长公共子序列,此时有len[m][n]=len[m-1][n-1]+1
-
如果a[m] != b[n],则有三种可能
- 如果c[k] = a[m],则c[0\~k]是a[0\~m]和b[0\~n-1]的最长公共子序列,有len[m][n] = len[m][n-1]
- 如果c[k] = b[n],则c[0\~k]是a[0\~m-1]和b[0\~n]的最长公共子序列,有len[m][n] = len[m-1][n]
- 如果c[k]既不等于a[m]也不等于b[n],那么len[m][n] = len[m-1][n] = len[m][n-1]
那么C[k]到底是哪一种情况呢?因为是求最大子序列和,那么当然取len最长的哪一种可能,也就是说,如果len[m][n-1] > len[m-1][n],那就说明c[k] = a[m],反之则说明c[k] = b[n],否则len[m][n-1] == len[m-1][n],则说明C[k]既不等于a[m]也不等于b[n]。
实际上,第三种情况可以被吸纳到前面任意一种情况里面去,因为既然C[k]既不a[m]也不等于b[n],那就说明它既是a[m-1]和b[n]的最长公共子序列,也是a[m]和b[n-1]的最长公共子序列,我们任选其一即可。
-
以上只能得出到底最长公共子序列有多长,为了输出这个子序列,那就是要指出当a[m] != b[n]时,到底是取了a[m],还是取了b[n],我们用另外一个数组来
choose[m][n]来指示取得是m还是n。当a[m]==b[n],该值取0,表明此时的a[m]或b[n]是最长公共子序列的一个元素,len[m][n-1] > len[m-1][n]时,该值取1,表示a[m],b[n]的最长公共子序列是a[m],b[n-1]的最长公共子序列,否则该值取-1,表示表示a[m],b[n]的最长公共子序列是a[m-1],b[n]的最长公共子序列。
#include <iostream>
#include <vector>

using namespace std;

template <typename T>
void LCS(const vector<T> &A, const vector<T> &B, vector<vector<int>> &len,
         vector<vector<int>> &choose) {

  int n = A.size();
  int m = B.size();

  for (int i = 1; i < n; ++i) {
    for (int j = 1; j < m; ++j) {
      if (A[i] == B[j]) {
        len[i][j] = len[i - 1][j - 1] + 1;
        choose[i][j] = 0; //表示此时c[k] = a[i] = b[j]
      } else {
        if (len[i - 1][j] >= len[i][j - 1]) {
          choose[i][j] = 1; //表示此时c[k] != a[i]
          len[i][j] = len[i - 1][j];
        } else {
          choose[i][j] = -1; //表示此时c[k] != b[i]
          len[i][j] = len[i][j - 1];
        }
      }
    }
  }
}

template <typename T>
void print_LCS(vector<T> &A, int i, int j, const vector<vector<int>> &choose) {

  if (i == 0 || j == 0) {
    return;
  }
  if (choose[i][j] == 0) {
    cout << A[i];
    print_LCS(A, i - 1, j - 1, choose);
  } else if (choose[i][j] == -1) {
    print_LCS(A, i, j - 1, choose);
  } else {
    print_LCS(A, i - 1, j, choose);
  }
}

int main() {

  int m, n;
  cin >> n;
  vector<char> A(n + 1);
  for (int i = 1; i <= n; ++i) {
    cin >> A[i];
  }
  cin >> m;
  vector<char> B(m + 1);
  for (int i = 1; i <= m; ++i) {
    cin >> B[i];
  }
  vector<vector<int>> len(n + 1, vector<int>(m + 1, 0));
  vector<vector<int>> choose(n + 1, vector<int>(m + 1, 0));
  LCS(A, B, len, choose);
  print_LCS(A, n, m, choose);
  return 0;
}
具体到这道题
这道题是稍微加强版的最长公共子序列问题,加强在哪里呢?加强在它允许其中一个数列重复,准确的说,是允许这姑娘喜欢的那个颜色的数列重复,这样可以这么去破这道题,假设这个姑娘喜欢的所有珠子颜色都是无限多个,再去求两个数列的最长公共子序列就可以了。那么怎么假设姑娘喜欢的珠子颜色无限多个呢?只要把没一个珠子都认为是10000个就可以了,因为给出的珠串最长才10000个。我们可以先给出代码。
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

void LCS(const vector<int> &A, const vector<int> &B, vector<vector<int>> &len) {

  int n = A.size();
  int m = B.size();

  for (int i = 1; i < n; ++i) {
    for (int j = 1; j < m; ++j) {
      if (A[i] == B[j]) {
        len[i][j] = len[i - 1][j - 1] + 1;
      } else {
        len[i][j] = max(len[i - 1][j], len[i][j-1]);
      }
    }
  }
}

int main() {

  int color_num, m, n;
  cin >> color_num >> n;
  vector<int> A(1, 0);
  for (int i = 1; i <= n; ++i) {
    int tmp;
    cin >> tmp;
    A.insert(A.end(), 10000, tmp);
  }
  cin >> m;
  vector<int> B(m + 1);
  for (int i = 1; i <= m; ++i) {
    cin >> B[i];
  }
  vector<vector<int>> len(n * 10000 + 1, vector<int>(m + 1, 0));
  LCS(A, B, len);
  cout << len[n*10000][m];

  return 0;
}
这解法虽然理论上可以运行,但实际上不用测试都知道内存肯定超限。那么还得继续分析这道题目。
我们设喜欢的数列为A[m],给出的序列为B[n],最长公共子序列为C[k],len[m][n]表示最长公共子序列的长度。继续之前的分析。
- A[m] == B[n]时,则C[k]=A[m]=B[n],本来应该有C[0\~k-1]是A[0\~m-1]和B[0~n-1]的最长公共子序列。但因为A可以重复,因此有可能假如B[n-1] = B[n],那么C[k-1]实际上还是A[m]和B[n-1]的公共子序列呢,两者取其长的一面,因此len[m][n]=max(len[m-1][n-1]+1,len[m][n-1] + 1)
- 其余相同。
则代码为:
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

void LCS(const vector<int> &A, const vector<int> &B, vector<vector<int>> &len) {
  int n = A.size();
  int m = B.size();

  for (int i = 1; i != n; ++i) {
    for (int j = 1; j != m; ++j) {
      if (A[i] == B[j])
        len[i][j] = max(len[i - 1][j - 1] + 1, len[i][j - 1] + 1);
      else
        len[i][j] = max(len[i - 1][j], len[i][j - 1]);
    }
  }
}

int main() {

  int color_num, m, n;
  cin >> color_num >> n;
  vector<int> A(n + 1, 0);
  for (int i = 1; i <= n; ++i) {
    cin >> A[i];
  }
  cin >> m;
  vector<int> B(m + 1);
  for (int i = 1; i <= m; ++i) {
    cin >> B[i];
  }
  vector<vector<int>> len(n + 1, vector<int>(m + 1, 0));
  LCS(A, B, len);
  cout << len[n][m];

  return 0;
}
1046 Shortest Distance
//用一个vector来表示某个节点到第一个节点之间的距离,之后只要相减就可以了
#include <iostream>
#include <vector>

using namespace std;

int main() {

  ios::sync_with_stdio(false);
  cin.tie(nullptr);
  int N;
  cin >> N;
  vector<int> total(N, 0);
  total[0] = 0;
  int tmp;
  for (int i = 1; i != N; ++i) {
    cin >> tmp;
    total[i] = total[i - 1] + tmp;
  }
  cin >> tmp;
  int all_dis = total[N-1] + tmp;
  int M;
  cin >> M;
  for (int i = 0; i != M; ++i) {
    int begin, end;
    cin >> begin >> end;
    if (begin == end) {
      cout << 0 << endl;
    } else {
      if (begin > end){
        int t = end;
        end = begin;
        begin = t;
      }
      int forward = total[end - 1] - total[begin - 1];
      int backward = all_dis - forward;
      cout << (forward > backward ? backward : forward) << endl;
    }
  }
  return 0;
}
1047 Student List for Course
最后一个节点超时
#include <algorithm>
#include <iostream>
#include <string.h>
#include <vector>

typedef struct Student {
  char name[5];
} Student;
std::vector<Student> sVec;  //优化4
std::vector<int> sVecHASH;

inline int myhash(char *s){ //优化3
  return (s[0]- 'A') * 26 * 26 * 10 + (s[1]- 'A') * 26 * 10 +
    (s[2]- 'A') * 10 + (s[3] - '0');
}

inline bool cmp(int s1, int s2) {
  return sVecHASH[s1] < sVecHASH[s2];   //优化3
}
int main() {

  setvbuf(stdin, new char[1 << 20], _IOFBF, 1 << 20);   //优化1
  setvbuf(stdout, new char[1 << 20], _IOFBF, 1 << 20);
  int s, c;
  scanf("%d%d", &s, &c);
  std::vector<std::vector<int>> cVec(c);
  for (int i = 0; i != c; ++i) { //优化2,避免发生vector的复制
    cVec.reserve(s);
  }
  sVec.resize(s);
  sVecHASH.resize(s);
  for (int i = 0; i < s; ++i) {
    int k;
    scanf("%s %d", sVec[i].name, &k); //优化4
    sVecHASH[i] = myhash(sVec[i].name);
    while (k--) {
      int cid;
      scanf("%d", &cid);
      cVec[cid - 1].push_back(i);
    }
  }
  for (int i = 0; i < (int)cVec.size(); ++i) {
    printf("%d %d\n", i + 1, (int)cVec[i].size());
    std::sort(cVec[i].begin(), cVec[i].end(), cmp);
    for (int j = 0; j < (int)cVec[i].size(); ++j) {
      printf("%s\n", sVec[cVec[i][j]].name);
    }
  }
  return 0;
}
吊诡的超时
400ms还超时,这是第一次遇到。网上随便找了十几份AC代码,但无一例外超时了最后一个节点。
上面的解法已经是我能想到的极限优化了。主要有这么几点:
- 优化1
为stdin和stdout设置很大的缓冲区,以尽量加快IO速度
-
优化2
提前为vector预留了空间,防止在不断push_back的时候发生容量不够导致的复制
-
优化3
对name这个字符串使用hash函数,得到一个int,以免在排序时反复调用strcmp,本题中name的长度是4,strcmp要对比4次,而用了hash后,每次对比只需要对比一个int即可。刚开始还想到直接把name的地址转化为一个unsigned指针,之后将其当做一个unsigned比较,但因为大小端的问题,实际上是将字符反着比大小,无法实现正确的排序,只好作罢。
-
优化4
使用一个数组专门存储姓名,完全避免了不必要的字符串复制,实际上,除了输入和输出以外,姓名字符串没有发生任何一次复制
而且这道题是丧心病狂的0通过率。

我一哥们怀疑是不是400ms的时限被陈越姥姥搞成40ms了,于是写了段代码测试了一下:
#include <time.h>

int main() {
  clock_t begin = clock();
  clock_t end;
  while (1) {
    end = clock();
    if ((end - begin) > 380000)
      break;
  }
  return 0;
}
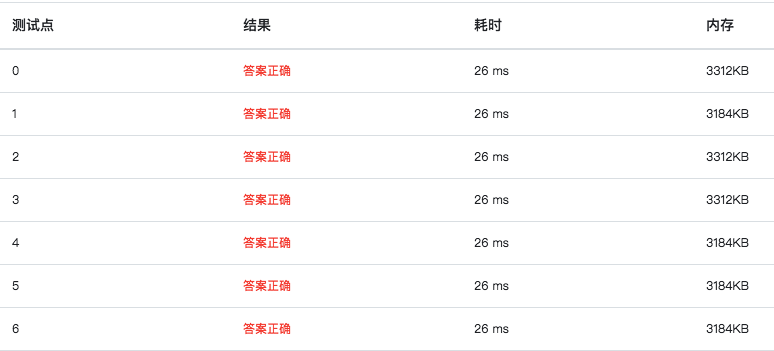
结果如下:

货真价实的400ms,能不能做出来就不归我管了……
1048 Find Coins
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

int find_other(const vector<int> &coins,const int should_pay,const int v1,int begin,int end){

  if (begin > end || begin == coins.size()){
    return -1;
  }
  int middle = (begin + end) / 2;
  if (v1 + coins[middle] == should_pay){
    return middle;
  }else if (v1 + coins[middle] < should_pay){
    return find_other(coins,should_pay,v1,middle + 1, end);
  }else{
    return find_other(coins,should_pay,v1,begin, middle - 1);
  }

}

int main() {

  ios::sync_with_stdio(false);
  int coin_num, should_pay;
  cin >> coin_num >> should_pay;
  vector<int> coins(coin_num);
  for (int i = 0; i != coin_num; ++i) {
    cin >> coins[i];
  }
  sort(coins.begin(), coins.end());
  int v2index = coin_num - 1;
  for (int i = 0; i != coin_num; ++i) {
    int v1 = coins[i];
    if (v1 >= should_pay / 2 + 1)
      break;
    v2index = find_other(coins,should_pay,v1,i + 1,coin_num-1);
    if (v2index != -1){
      cout << v1 << " " << coins[v2index] << endl;
      return 0;
    }
  }
  cout << "No Solution" << endl;
  return 0;
}
1049 Count Ones
//个位数如果超过了1,那么10位数每增加1,个位数的1就增加1.
//十位数的1取决于个位数,十位数的1的个数,等于个位数的数字加1
//百位数的1取决于后面的数字,是后两位数字+1
//之后百位数每增加1,十位数和个位数的1就增加1倍。

#include <iostream>
#include <stdio.h>

using namespace std;

int compute(int N) {
  int factor = 1;
  int low = 0;
  int high = 0;
  int now = 0;
  int cnt = 0;

  while (N / factor != 0) {
    now = (N / factor) % 10;
    high = N / factor / 10;
    low = N % factor;

    switch (now) {
    case 0:
      cnt += high * factor;
      break;
    case 1:
      cnt += high * factor + low + 1;
      break;
    default:
      cnt += (high + 1) * factor;
    }

    factor *= 10;
  }

  return cnt;
}

int main() {
  int N;
  while (scanf("%d", &N) != EOF) {
    cout << compute(N) << endl;
  }

  return 0;
}
1050 String Subtraction
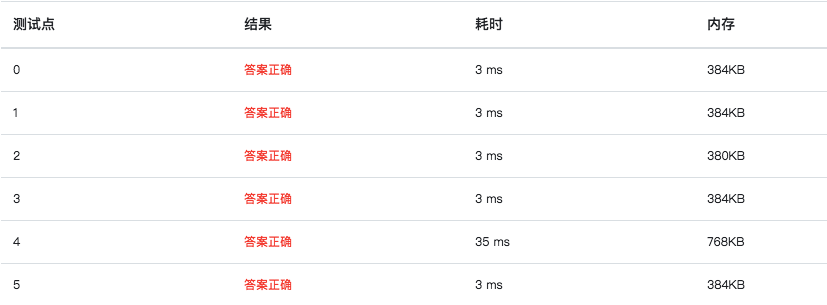
//少量输入和大量查找的活儿,最适合set干
//当然也可以vector排序后二分查找。但是反正set已经3ms过所有节点了,还费那事干嘛。
#include <iostream>
#include <set>
#include <string>

using namespace std;

int main() {

  ios::sync_with_stdio(false);
  string S1;
  getline(cin, S1);
  set<char> S2;
  char c;
  while ((c = cin.get()) != '\n') {
    S2.insert(c);
  }
  string res;
  for (auto it = S1.begin(); it != S1.end(); ++it) {
    if (S2.find(*it) == S2.end())
      res += *it;
  }
  cout << res << endl;
  return 0;
}
0 条评论